
In der heutigen datengetriebenen Welt wird der effiziente Zugriff auf Informationen immer wichtiger. Unternehmen, Forschungseinrichtungen und Fachleute müssen grosse Mengen an Dokumenten, Berichten und unstrukturierten Daten effizient durchsuchen. Klassische Suchverfahren stossen dabei an Grenzen, wenn es darum geht, semantische Zusammenhänge zu verstehen und präzise Antworten auf konkrete Fragen zu liefern.
Hier setzt Retrieval-Augmented Generation (RAG) an: eine Methode, die die Leistungsfähigkeit von Sprachmodellen mit einer robusten Suchstrategie verbindet. Herkömmliche Suchmaschinen gleichen oft nur Schlüsselwörter ab. Ein RAG-System dagegen beschränkt die Antwort auf einen bestimmten Kontext, indem es semantische Ähnlichkeiten erkennt und für präzisere Antworten nutzt.
Ziel des Prototyps war ein System, das Suche und Entscheidung beschleunigt und zugleich hochwertige Antworten liefert. Wo Zeit knapp ist, bringt das einen spürbaren Produktivitätsgewinn: bei der Recherche, im Kundenservice oder bei der internen Dokumentation grosser Unternehmen.
In diesem Beitrag stelle ich einen Prototyp für ein Information-Retrieval-System vor, das mit RAG arbeitet. Er ist mit Flask als Web-Backend aufgebaut, nutzt ChromaDB für Suchanfragen auf Basis von Embeddings und bietet eine einfache Web-Oberfläche.
Technologische Grundlage
Das System besteht aus diesen Hauptkomponenten:
- Flask und FastAPI für API und Benutzeroberfläche.
- ChromaDB für das Retrieval auf Basis von Embeddings.
- LangChain zur Orchestrierung von Retrieval und Generierung.
- Modelle von Hugging Face für Embeddings und Generierung.
- PyMuPDF für die Verarbeitung von PDF-Dokumenten.
- Web-Frontend aus HTML, CSS und JavaScript für die Bedienung.
Die wichtigsten Bibliotheken stehen in der Datei requirements.txt, unter anderem:
chromadb==0.5.3langchain==0.2.14sentence-transformers==3.1.0transformers==4.44.0Flask==3.0.3
Diese Kombination ermöglicht ein effizientes Information Retrieval mit semantischem Verständnis.
Systemarchitektur und Ablauf
Der Prototyp besteht aus mehreren Modulen:
app.py: die zentrale Flask-Anwendung, die Anfragen entgegennimmt und verarbeitet.routes.py: die API-Endpunkte für das Hochladen, Indexieren und Abfragen von Dokumenten.utils.py: Hilfsfunktionen für die PDF-Verarbeitung und die Berechnung der Embeddings.config.py: die Konfiguration des Systems.LLM.htmlundupload.html: die Web-Oberfläche für Suchanfragen und das Hochladen von Dokumenten.style.css: die Gestaltung der Oberfläche.
Ein typischer Ablauf:
- Ein Dokument, zum Beispiel ein PDF, wird über die Web-Oberfläche hochgeladen.
- Der Text wird extrahiert und in kleinere Textblöcke zerlegt.
- Für jeden Textblock entsteht ein Embedding, das in ChromaDB gespeichert wird.
- Bei einer Suchanfrage wird auch die Frage als Embedding berechnet.
- ChromaDB führt eine Vektorsuche durch und gibt die relevantesten Passagen zurück.
- Ein Sprachmodell formuliert auf dieser Grundlage eine zusammenhängende Antwort.
- Die Web-Oberfläche zeigt die Antwort zusammen mit den Quellen aus den Dokumenten.
Einblick in den Code
Ein kurzer Blick auf die Suchfunktion mit ChromaDB (im Prototyp etwas anders umgesetzt):
from langchain.chains import RetrievalQA

query = request.form.get('inputString')
retriever = vector_store.as_retriever()

qa_chain = RetrievalQA.from_chain_type(
    llm=llm,
    chain_type='stuff',
    retriever=retriever,
    return_source_documents=True,
)

result = qa_chain({'query': query})
Die Funktion nimmt die Frage entgegen, wandelt sie in einen Embedding-Vektor um und führt eine Ähnlichkeitssuche durch. Die besten Treffer dienen als Kontext für die Antwort des Sprachmodells.
Benutzeroberfläche
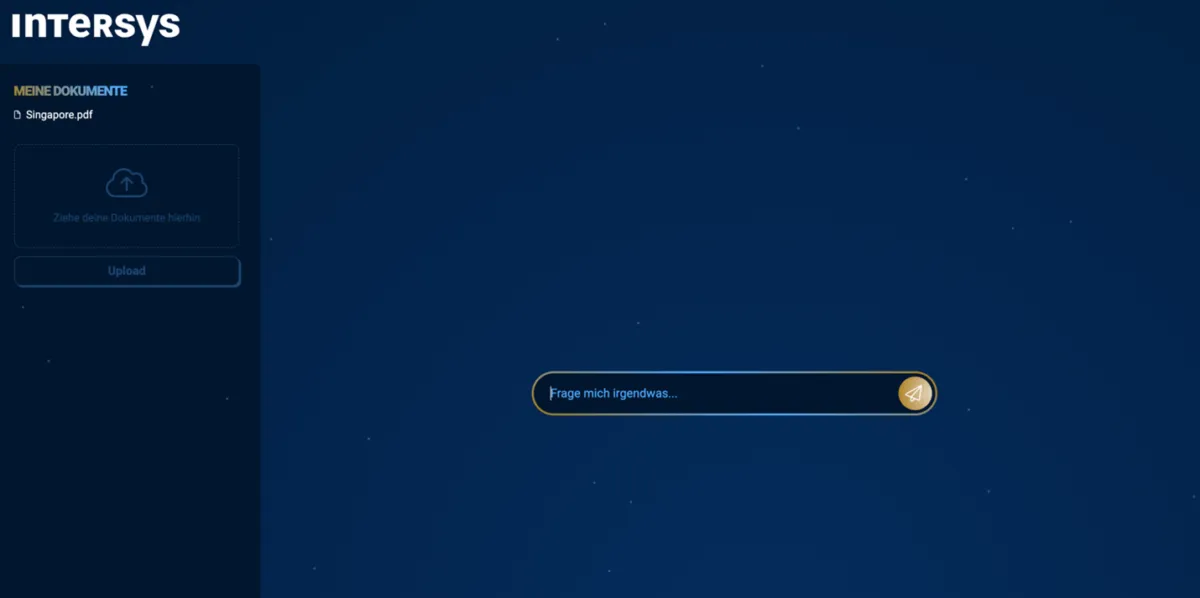
Die Web-Oberfläche ist in LLM.html und upload.html definiert und bietet:
- ein Eingabefeld für Fragen mit direkter Anzeige der Antwort,
- die gefundenen Dokumente und die relevanten Abschnitte,
- das Hochladen von Dokumenten mit einer Übersicht der bereits gespeicherten Dateien,
- eine Darstellung, die sich verschiedenen Bildschirmgrössen anpasst.
Herausforderungen und Ausblick
Während der Entwicklung zeigten sich einige Herausforderungen:
- Embeddings optimieren: Die Wahl des Modells beeinflusst die Suchqualität erheblich.
all-MiniLM-L6-v2bietet eine gute Balance zwischen Qualität und Geschwindigkeit. - Grosse Dokumente speichern: Die Aufteilung in Textblöcke (Chunking) verhindert, dass lange Texte die Datenbank überlasten.
- Antwortzeit verkürzen: Caching und parallele Verarbeitung reduzieren die Wartezeit.
- Bedienung vereinfachen: Die Oberfläche erlaubt einen schnellen Wechsel zwischen Hochladen und Suchen.
Der Prototyp ist noch einfach gehalten. Geplant sind weitere Verbesserungen, etwa leistungsstärkere Sprachmodelle oder eine erweiterte Darstellung der Suchergebnisse.
Fazit: vielseitig einsetzbar
Der Prototyp zeigt, wie sich RAG in einem Information-Retrieval-System wirksam einsetzen lässt. Die Web-Oberfläche erleichtert die Nutzung und erlaubt es, Dokumente interaktiv zu erkunden.
Die Einsatzmöglichkeiten reichen von einfachen Rechercheaufgaben bis zu komplexen Anwendungen. Als zentrale Wissensbasis gibt ein RAG-System Mitarbeitenden schnellen Zugriff auf interne Reglemente. Es kann aber auch anspruchsvollere Aufgaben übernehmen, zum Beispiel externe Vorschriften wie die Regelwerke der FDA automatisch mit Produktbeschreibungen in der Medizinalindustrie abgleichen. Das erleichtert die Einhaltung regulatorischer Anforderungen und macht das Dokumentenmanagement effizienter.